Synth-Ethics: Moral Outlook as a Controlled Variable in Synthetic Training Data
Hanna Shcharbakova, Pieter Delobelle, Anastasia Stasenko,
Carlos Rosas-Hinostroza, Pierre-Carl Langlais
UserSim @ NeurIPS 2026
It’s All Training: A Fully Synthetic Single-Stage Recipe for LLMs
Pierre-Carl Langlais, Pieter Delobelle, Yannick Detrois, Pavel Chizhov,
Carlos Rosas-Hinostroza, Neil Si Smail, Benjamin Burtin, Hanna Shcharbakova,
Ivan Yamshchikov, Anastasia Stasenko
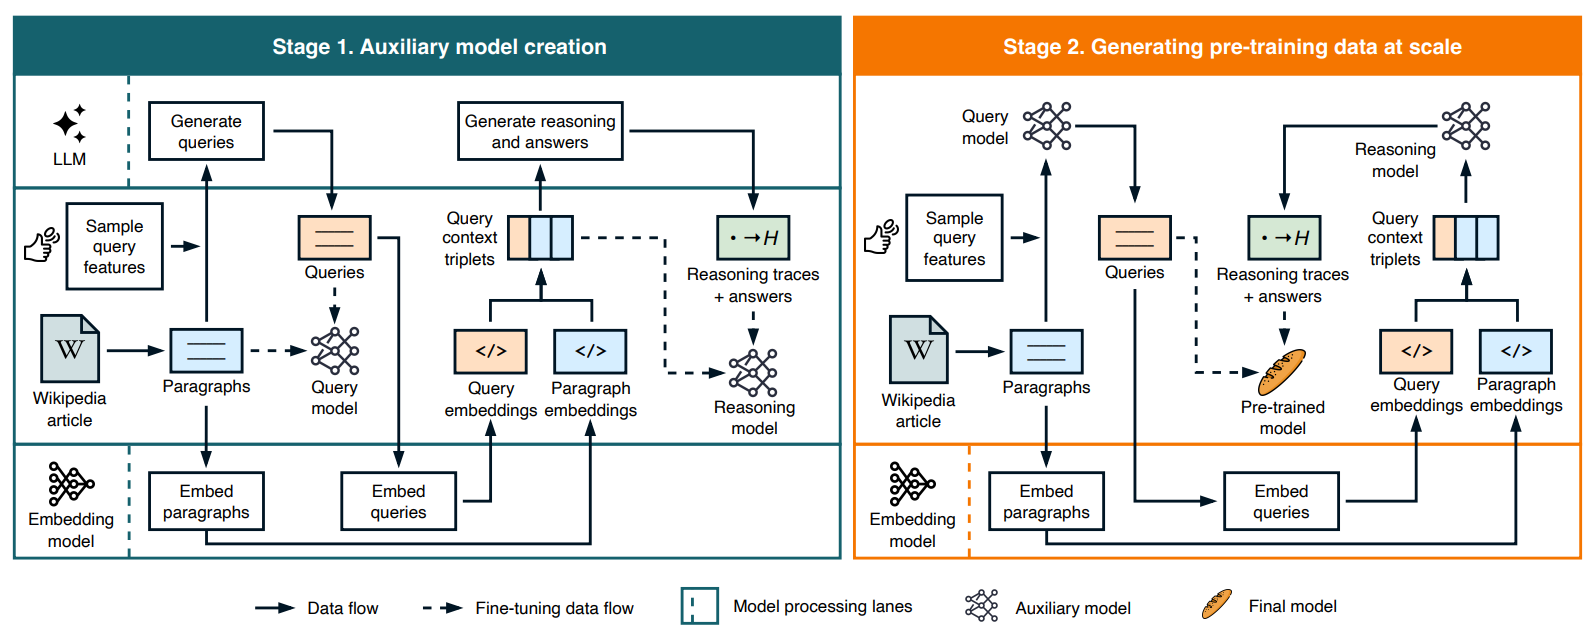
Open for a bit more detailSYNTH pipeline for the memorization task. At Stage 1, auxiliary models are fine-tuned on LLM-generated data. At Stage 2, these models are used to produce synthetic training data at scale.
2025
When Scale Meets Diversity: Evaluating Language Models on Fine-Grained Multilingual
Claim Verification
Hanna Shcharbakova, Tatiana Anikina, Natalia Skachkova,
Josef van Genabith
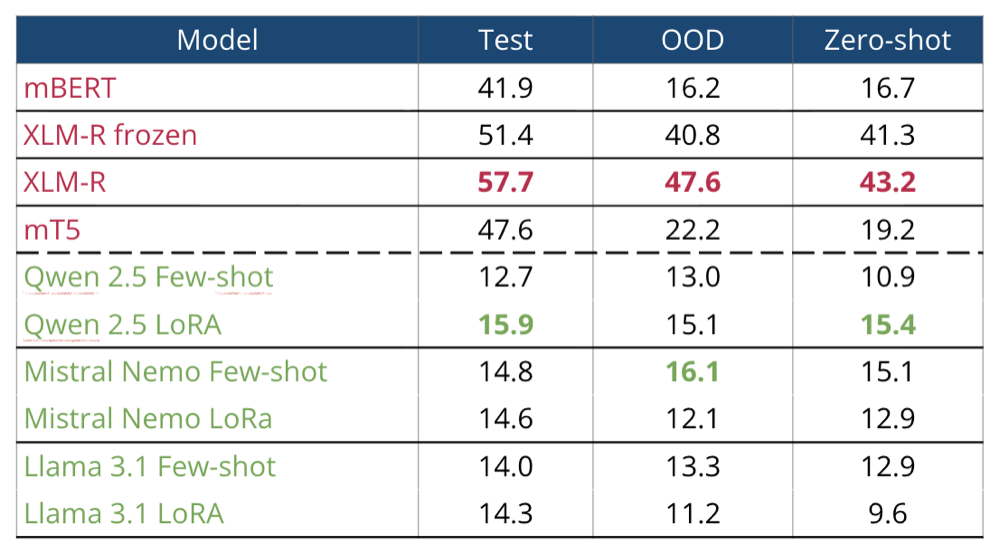
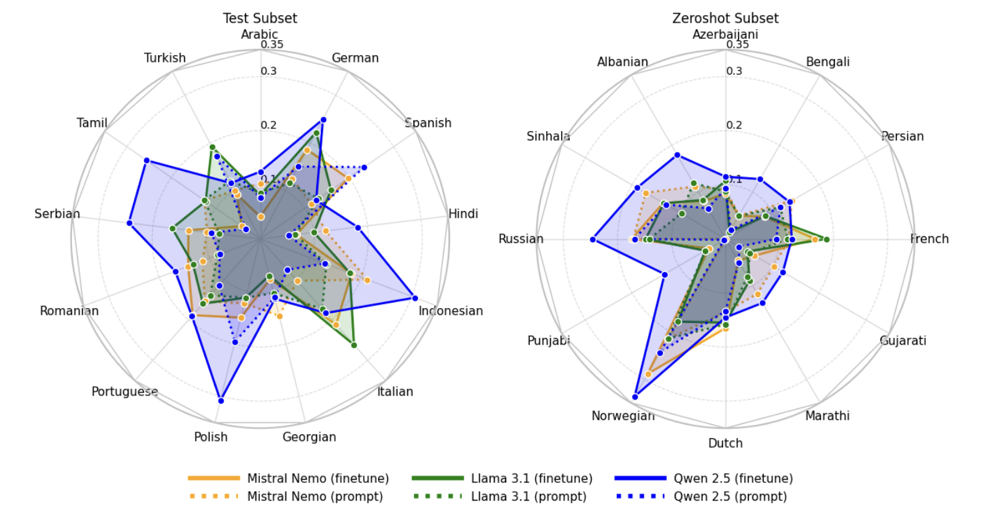
Open for a bit more detailMacro-F1 across evaluation subsets for the Claim+Evidence configuration: specialised encoders against instruction-tuned LLMs.
Cross-Lingual Fact Verification: Analyzing LLM Performance Patterns across Languages
Hanna Shcharbakova, Tatiana Anikina, Natalia Skachkova,
Josef van Genabith